AI boti a crawlery zatěžují web: jak je omezit
Aktualizováno 29. 10. 2026
Krátká odpověď: AI crawlery, které sbírají obsah pro ChatGPT, Gemini nebo Perplexity, mohou web zatížit podobně jako zátěžový test. Samotný robots.txt nestačí, protože ho část botů ignoruje. Pomáhá kombinace monitoringu a analýzy access logů, cache a CDN, WAF a rate limitingu. Plošné blokování přitom nemusí být správná cesta.
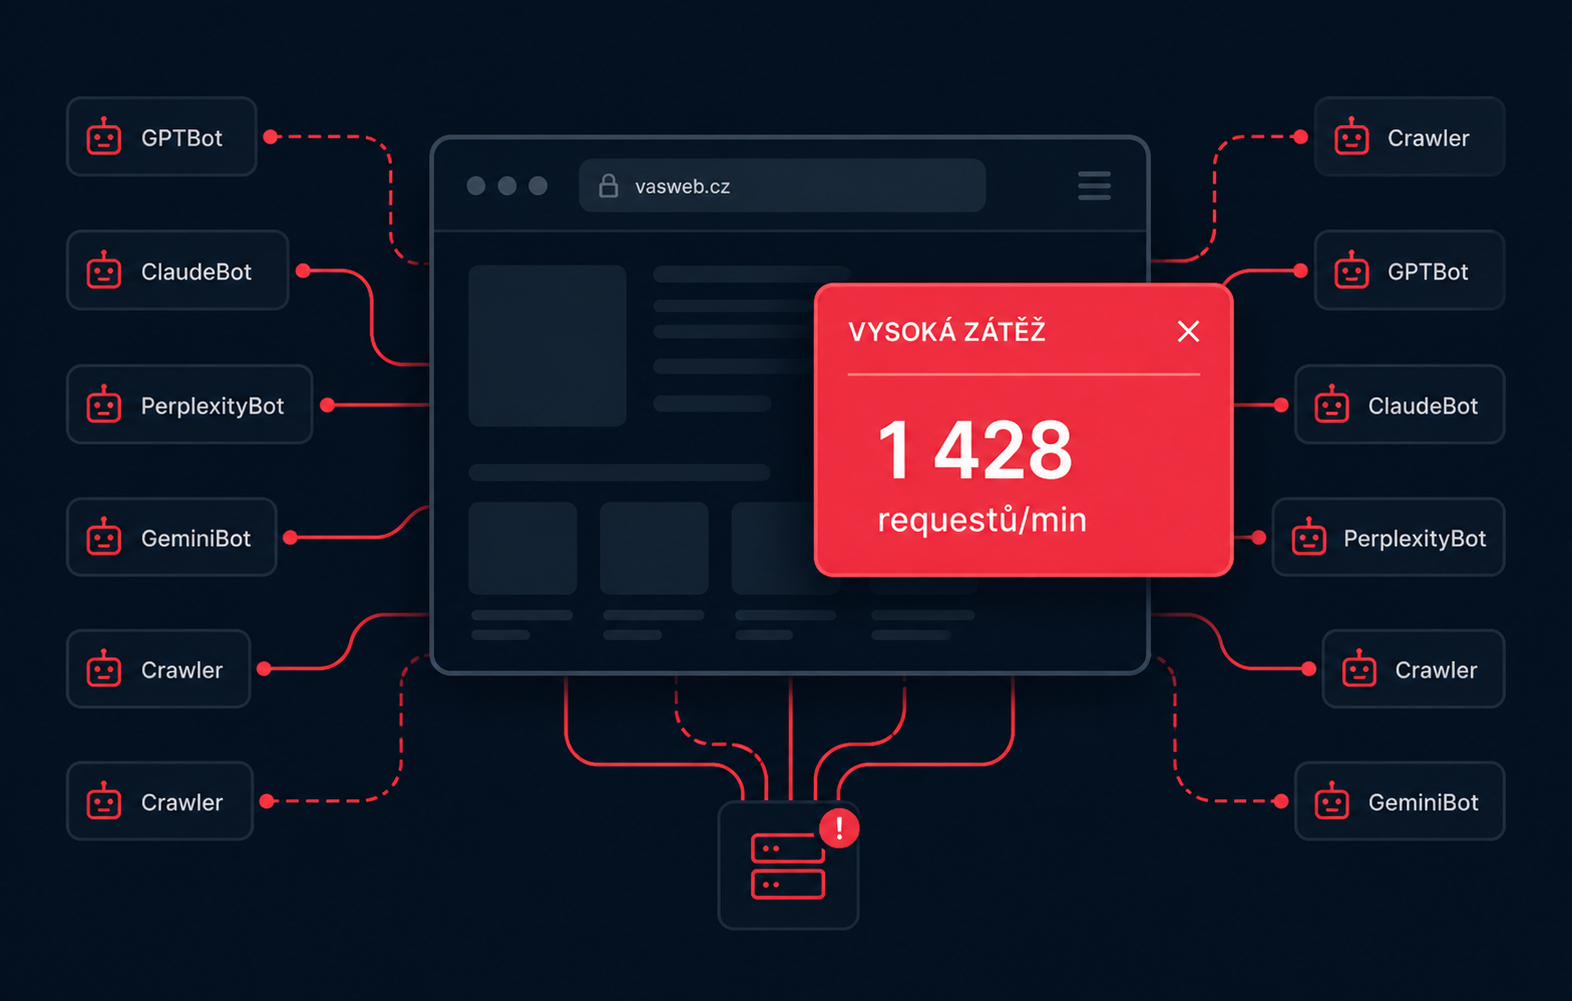
Internet se mění rychleji, než si většina firem uvědomuje. Vedle klasických uživatelů dnes weby ve velkém navštěvují AI crawlery, které sbírají obsah pro ChatGPT, Gemini, Perplexity a další AI systémy. Problém je, že tito boti se často nechovají jako běžní návštěvníci. Generují výrazně vyšší zátěž, procházejí obrovské množství stránek a dokážou zpomalit i relativně dobře postavený web.
AI boti nejsou klasický crawler
Webové crawlery existují dlouho. Googlebot nebo SeznamBot jsou standardní součástí internetu už roky. Nová generace AI crawlerů se ale často chová výrazně agresivněji:
- prochází velké množství podstránek najednou
- otevírá hluboké části webu
- intenzivně zatěžuje dynamické stránky
- posílá souběžné požadavky
- opakovaně načítá obsah
Z pohledu serveru se jejich chování často podobá spíš zátěžovému testu než běžnému procházení webu.
Největší problém vzniká hlavně u:
- e-shopů
- rozsáhlých katalogů
- webů s filtrováním
- dynamických aplikací
- znalostních bází
- obsahových webů s velkým množstvím URL
Jak poznat, že problém možná řešíte i vy
Časté příznaky:
- vysoké TTFB bez odpovídající návštěvnosti
- neobvyklé špičky provozu v noci
- velké množství požadavků na málo navštěvované URL
- vysoká zátěž databáze
- nárůst přenesených dat
- neznámé nebo podezřelé user-agenty
Problém je, že mnoho AI crawlerů navíc nijak neusnadňuje svou identifikaci. Někteří maskují user-agent nebo ignorují pravidla robots.txt.
Jak AI crawlery najít v access logu
Prvním krokem je projít access log serveru nebo CDN a seřadit požadavky podle user-agenta, IP adresy a počtu požadavků za časový úsek. Velcí provozovatelé AI se v user-agentu obvykle podepisují, například:
- GPTBot, OAI-SearchBot a ChatGPT-User (OpenAI)
- ClaudeBot, Claude-SearchBot a Claude-User (Anthropic)
- PerplexityBot a Perplexity-User (Perplexity)
- CCBot (Common Crawl, jehož data využívají i AI modely)
- Bytespider (ByteDance)
Samotný user-agent ale nestačí, protože ho lze snadno podvrhnout. Pravého bota poznáte tak, že jeho IP adresa patří do rozsahů, které provozovatel zveřejňuje. Rozsahy zveřejňují OpenAI, Anthropic, Perplexity, Common Crawl i Google. Google a Common Crawl umožňují i ověření přes reverzní DNS. Požadavky, které se za známého bota jen vydávají, je bezpečné rovnou blokovat.
Robots.txt dnes často nestačí
Mnoho firem stále předpokládá, že robots.txt problém vyřeší. Ve skutečnosti je to spíš doporučení než ochrana. Seriózní vyhledávače ho respektují. Část AI crawlerů ale:
- pravidla ignoruje
- obchází
- nebo se vůbec nepřiznává
U botů, kteří pravidla respektují, stačí jednoduchý zápis. Například celý web pro GPTBot zakážete takto:
User-agent: GPTBot
Disallow: /
Na boty, kteří robots.txt ignorují nebo se nepodepisují, ale žádný zápis nezabere.
Proto dnes ochrana webu vyžaduje aktivnější přístup:
- WAF
- rate limiting
- bot management
- CDN vrstvy
- monitoring provozu
- behaviorální analýzu
Bez toho firmy často ani nevidí, co se na jejich infrastruktuře děje.
Největší problém není jen výkon
AI crawlery nejsou jen problém výkonu.
Mění ekonomiku webu.
Část obsahu dnes AI systémy přečtou, zpracují a zobrazí uživateli bez návštěvy původního webu. To znamená:
- méně prokliků
- vyšší infrastrukturové náklady
- větší tlak na výkon
- změnu SEO strategie
- vyšší důležitost značky a autority
Web už dnes často nečtou primárně lidé. Čtou ho stroje, které informace dále distribuují.
Co dnes dává největší smysl
Nejhorší varianta je problém ignorovat.
Firmy by minimálně měly:
- monitorovat provoz a zátěž serveru
- analyzovat access logy
- sledovat neobvyklé vzorce procházení
- nasadit CDN a cache vrstvu
- řešit rate limiting
- oddělit kritické části aplikace
- pravidelně auditovat infrastrukturu (s tím pomáhá správa serverů a infrastruktury)
Velmi často pomůže už základní kombinace:
- Cloudflare
- správně nastavená cache
- WAF
- monitoring
- omezení agresivního crawlování
Při správném nastavení to výrazně sníží tlak na server bez negativního dopadu na SEO nebo viditelnost v AI vyhledávání.
Úplné blokování AI botů nemusí být správná cesta
Firmy dnes často řeší: „Máme AI crawlery úplně zakázat?“ Odpověď není univerzální.
Některé AI systémy:
- mohou přivádět návštěvnost
- ovlivňují viditelnost značky v AI vyhledávání
- pracují s vaším obsahem jako zdrojem
Proto bývá lepší:
- řídit
- filtrovat
- limitovat
- prioritizovat
než všechno plošně blokovat.
Strategie se dnes začíná podobat SEO, protože nejde jen o zákaz. Jde o kontrolu a prioritizaci.
AI traffic bude dál růst
Tohle není krátkodobý problém.
AI agenti a crawlery budou tvořit stále větší část internetového provozu. Podle zprávy Imperva Bad Bot Report 2025 tvořil automatizovaný provoz v roce 2024 už 51 % veškerého webového provozu a 37 % připadalo na škodlivé boty. Čísla zahrnují všechny boty, nejen AI.
Firmy, které:
- neřeší monitoring
- neznají svůj traffic
- nemají ochranu infrastruktury
- spoléhají jen na základní hosting
budou tyto dopady cítit stále víc.
Pokud je web pro firmu důležitý, vyplatí se spravovaný hosting s monitoringem 24/7 a možností rychle navýšit výkon, například během sezóny.
Nejde jen o výkon. Jde o připravenost webu na nový způsob fungování internetu.
Řešíte zpomalování webu, nečekané špičky zátěže nebo podezřelý provoz? Ozvěte se nám. Pomůžeme vám odhalit slabá místa, navrhnout vhodná opatření a připravit web na rostoucí nároky moderního online prostředí. Jak pracujeme se servery, monitoringem a ochranou provozu, popisujeme u služby správa serverů a infrastruktury.
Časté otázky k AI botům
Jak zablokovat GPTBot?
Do souboru robots.txt v kořeni webu přidejte řádky User-agent: GPTBot a Disallow: /. GPTBot podle OpenAI pravidla robots.txt respektuje. Zákaz se ale týká jen tohoto bota. Ostatní crawlery OpenAI (například OAI-SearchBot) mají vlastní user-agent a vlastní pravidla. Kdo chce zakázat trénink, ale zůstat ve vyhledávání ChatGPT, zablokuje GPTBot a OAI-SearchBot nechá povolený.
Neuškodí blokování AI botů viditelnosti v AI vyhledávání?
Může. Některé AI systémy přivádějí návštěvnost a ovlivňují, jak se o vaší značce v AI odpovědích mluví. Proto bývá lepší boty řídit a omezovat než plošně blokovat. Provozovatelé AI navíc často oddělují boty pro trénink modelů od botů pro vyhledávání. U OpenAI je tréninkový GPTBot a vyhledávací OAI-SearchBot, u Anthropicu tréninkový ClaudeBot a vyhledávací Claude-SearchBot. PerplexityBot slouží jen vyhledávání. Zákaz tréninkových botů vás z AI vyhledávání nevyřadí, zákaz vyhledávacích ano. U Googlu řídí použití obsahu pro trénink Gemini token Google-Extended, který podle Googlu nemá vliv na zařazení ve vyhledávání Google.
Respektují AI boti robots.txt?
Boti velkých provozovatelů (GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot) ano. Výjimkou jsou boti, kteří stránku stahují na pokyn konkrétního uživatele, například ChatGPT-User nebo Perplexity-User. Ty podle svých provozovatelů pravidla robots.txt dodržovat nemusí. Část dalších crawlerů pravidla ignoruje, obchází nebo se nepodepisuje. Na ty robots.txt nezabere a pomůže až WAF, rate limiting nebo bot management.
Omezí rate limiting i Googlebot?
Pokud se nastaví plošně, může. Proto se rate limiting a pravidla WAF nastavují tak, aby ověření vyhledávací boti prošli. Ověřují se podle IP rozsahů nebo reverzního DNS, ne podle user-agenta, který lze podvrhnout. Omezení pak dopadne hlavně na agresivní nebo podvržený provoz. Pokud je potřeba Googlebot krátkodobě přibrzdit, Google doporučuje vracet kód 429 nebo 503. Déle než 1–2 dny to ale škodí indexaci.